什么是 Lakebase
Lakebase 是一类把 OLTP 的权威数据放在云对象存储上的架构:事务引擎仍是 PostgreSQL,数据以 PostgreSQL 页的格式落在对象存储里。宣传中常被提到的存算分离、计算缩到零、秒级分支,大多在上一代云数据库里已经出现过;它真正新增的部分更窄:持久层换成了通用对象存储,页格式在引擎之外可读,任意已提交的 LSN 都能作为跨引擎的一致性锚点。这篇先把「不新的部分」剥掉,再讨论剩下的部分好在哪里、对谁有用。
纵向分层与横向能力:Agent 时代的 Go 依赖设计
代码越来越多由 agent 生成之后,「写代码」不再是架构需要节省的主要成本;定位代码、验证行为、评审 diff、控制改动范围变得更贵。这篇从这个成本变化出发,把项目看成纵向管线(controller → service → adapter)与横向能力(log、metrics、LLM、agent)交织的矩阵,比较几种常见接口做法各自带来什么,再给出一条相对稳的路径:分层决定代码放在哪,接口只标记需要隔离、替换、验证或装饰的依赖边界。
Agent RL(七):跑通一个可验证的训练闭环
用六个工具动作跑通采样、终局评分、组内优势、裁剪更新和评估。先验证参数确实被结果更新了,再接本地语言模型;同时用成功轨迹 SFT 做对照,并说清这个实验能证明什么、不能证明什么。
Agent RL(六):安全隔离与 Harness 解耦
隔离的核心问题是信任边界画在哪里。划分原则只有一条:执行模型产出的地方就不可信,包括评分器;持有凭证、训练元数据和私有答案的东西,都要放在边界的另一侧。harness 解耦和安全隔离,其实是同一条边界的两面。
Agent RL(五):GPU 训练与 CPU 环境如何协同
Agent RL 系统的核心张力只有一个:想让 GPU 一直忙,就得让采样和训练重叠;想让样本可信,就得让样本来自当前的策略。所有的架构选择都是在这两者之间找位置,而策略版本号是让这个取舍可以度量、可以检查的唯一锚点。
Agent RL(四):长轨迹上的信用分配
终局成功不能证明每一步都好。结果监督、价值基线和过程奖励给出的是不同的信息。任何更细粒度的信号,都要说清它从哪里来、什么时候可靠、会诱导出什么行为。
Agent RL(番外):DPO 到底补充了什么
这是一篇可选的背景文章,只帮助理解后训练里「偏好优化」和「环境交互式 RL」怎么分工,不是阅读 PPO、GRPO 和 Agent RL 主线的前置条件。
Agent RL(三):从 PPO 到 GRPO
PPO 和 GRPO 要回答的是同一个问题:一次选择比基线好多少。PPO 通常训练一个 critic 来给出基线,GRPO 则用同一道题的一组采样互相比较。在此之上,clip、KL、长度归一化各自管着不同的事,名字相同的算法,实际优化的目标可能并不相同。
Agent RL(二):从工具调用到可训练轨迹
一条 Agent 轨迹要能用于训练,先得把四个角色拆开:模型、harness、可写环境、评分器。拆开之后才能回答几个关键问题:哪些是动作、哪些是观察,哪些 token 参与训练,一次失败究竟来自策略还是基础设施。
Agent RL(一):为什么需要 Agent RL
后训练是一类训练流程,RL 是其中一种可选的优化方法。Agent RL 的特别之处在于:它用策略自己在环境里交互得到的结果,去改变模型下一次做选择的概率。这一篇说清它要解决什么问题、和 SFT 怎么分工、训练的到底是什么,以及不可微的工具链为什么不妨碍求梯度。
倒排索引(一):从 CJK 分词到 Term Dictionary 与 Posting List
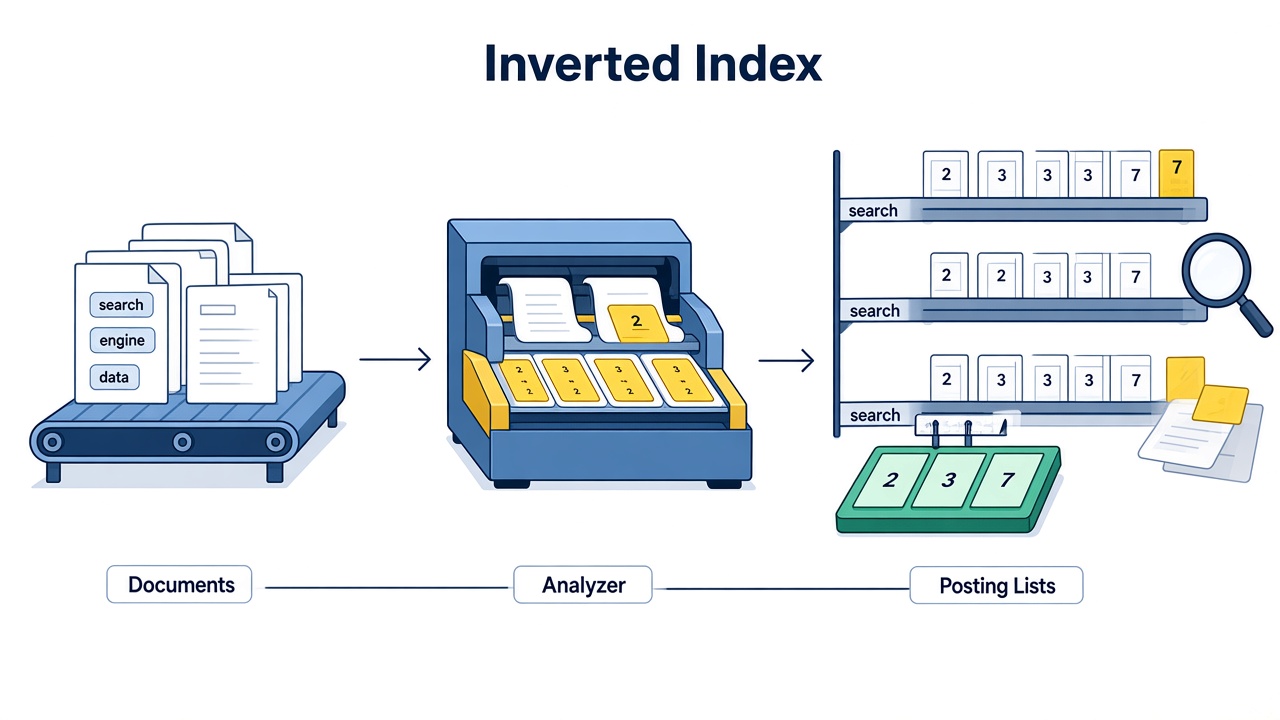
倒排索引不只是
term → docID[]。在这条映射出现之前,Analyzer 必须先决定中文里的「词」是什么;在它之后,Term Dictionary 负责从海量有序词项中定位词块,Posting List 再携带 docID、词频与位置。本文用四篇中文文档贯穿写入链路,把 CJK 分词、词典、倒排表、压缩与 Segment 串成一个可查询的结构。
倒排索引(二):从 Posting Iterator 到 BM25 排序
Term Dictionary 找到的不是最终结果,而是几条等待消费的 Posting Iterator。查询执行器要让这些有序流完成 AND、OR 与 Phrase 匹配,再用 tf、df 和字段长度计算 BM25。本文继续使用四篇中文文档,逐步走完从查询字符串到排名分数的数据流。
倒排索引(三):WAND、Block-Max 与 Top-K 动态剪枝
BM25 能算出相关性,不代表每篇命中文档都值得精确打分。Top-K 搜索只关心前几名:结果堆产生竞争阈值,WAND 用 term 级分数上界跳过不可能竞争的 docID,Block-Max 再把上界缩小到局部块。只要上界安全,被跳过的文档就不可能进入 Top-K,最终排名仍然精确。
向量检索(二):量化在保住什么
向量量化要保住的不是向量本身,而是排序:用更少的比特表示向量之后,任意一个查询算出来的 Top-K 仍然大体正确。沿着「每维少存几位」一路压下去,到 1 bit 的裸 BQ 会暴露两个问题:估计有偏,比特用得不均。此后的方法分成两条路:PQ 一系向数据学码本,RaBitQ / TurboQuant 一系先把数据旋转得均匀,再配一个无偏估计器。两条路比到最后,比的不是谁省了更多比特,而是谁能说清楚自己的估计错了多少。
向量检索(一):索引在赌近邻在哪里
向量索引的名字很多,思想只有几种。每一种索引都是对「近邻会出现在哪里」的一个赌注:KD-tree 赌近邻和查询落在同一个格子里,LSH 赌随机切很多次总能切对几次,IVF 赌近邻在同一个簇里,图索引赌沿着近的点一路走能走到近邻,DiskANN / SPANN 赌粗信息就够导航。这篇沿着「每个赌注在哪里输掉、下一个赌注怎么补上」这条线,把主流索引串成一条演进链,细节只保留理解思想所必需的部分。