倒排索引(一):从 CJK 分词到 Term Dictionary 与 Posting List
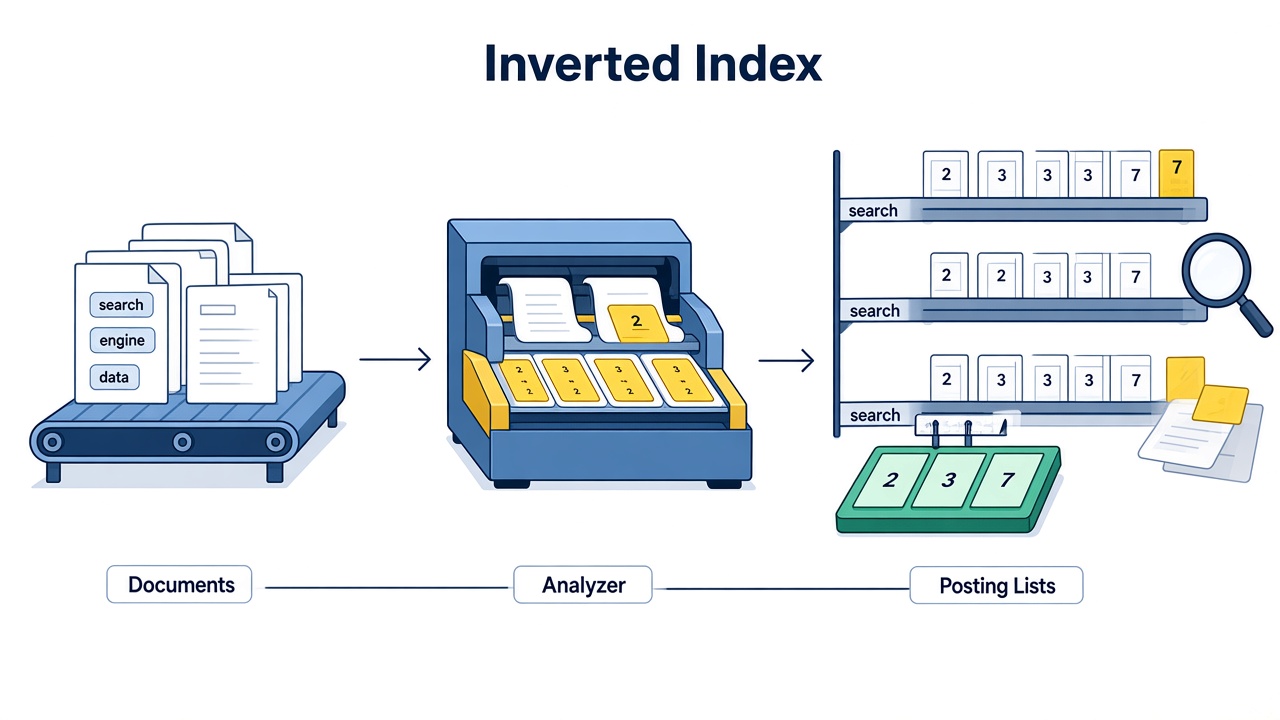
倒排索引不只是
term → docID[]。在这条映射出现之前,Analyzer 必须先决定中文里的「词」是什么;在它之后,Term Dictionary 负责从海量有序词项中定位词块,Posting List 再携带 docID、词频与位置。本文用四篇中文文档贯穿写入链路,把 CJK 分词、词典、倒排表、压缩与 Segment 串成一个可查询的结构。
本文是倒排索引系列的第一篇:
- 从 CJK 分词到 Term Dictionary 与 Posting List(本文)
- 从 Posting Iterator 到 BM25 排序
- WAND、Block-Max 与 Top-K 动态剪枝
1. 先固定一组贯穿全文的数据
抽象的
term → postings很容易懂,也很容易让人误以为实现只是一个哈希表。先把字符串、token、词典项与 posting 全部落到同一组数据上。
假设索引里只有一个全文字段 title,包含四篇文档:
doc 0: 数据库索引原理
doc 1: 数据库索引优化与数据库实践
doc 2: 数据仓库索引设计
doc 3: 数据库查询优化
本文暂时假定一个领域分词器产生如下 token。停用词「与」被移除,位置是否保留空洞由具体配置决定;为简化示例,这里把剩余 token 的 position 连续编号:
doc 0: 数据库@0, 索引@1, 原理@2
doc 1: 数据库@0, 索引@1, 优化@2, 数据库@3, 实践@4
doc 2: 数据仓库@0, 索引@1, 设计@2
doc 3: 数据库@0, 查询@1, 优化@2聚合后,title 字段里会出现这样的两层结构:
(title, 数据库)
  stats: docFreq=3, totalTermFreq=4
  postings:
    doc 0: freq=1, positions=[0]
    doc 1: freq=2, positions=[0, 3]
    doc 3: freq=1, positions=[0]

(title, 索引)
  stats: docFreq=3, totalTermFreq=3
  postings:
    doc 0: freq=1, positions=[1]
    doc 1: freq=1, positions=[1]
    doc 2: freq=1, positions=[1]
这里已经能看到三个边界:
- 完整查找键不是裸
term,而是field + term。title:数据库与body:数据库属于两套词典和统计。 docFreq是包含该词的文档数;同一文档出现两次仍只计一篇。totalTermFreq是所有文档中出现次数之和,因此「数据库」分别为 3 和 4。
倒排方向与普通的正排方向正好相反:
正排:docID → 这篇文档有哪些 token
倒排:(field, term) → 哪些 docID 包含它
查「数据库」不再打开四篇原文逐一检查,而是定位 (title, 数据库) 后直接读取 [0, 1, 3]。
这和 B+ 树并不冲突。B+ 树的键通常是一列完整、可排序的值;倒排索引把一段文本展开为数量不定的 token,每个 token 都成为可查入口。一次写入会变成许多 posting,换来包含、布尔、短语和相关性 Top-K 查询。
还要避免一个同名误会:向量检索里的 IVF(Inverted File)保存的是「聚类中心 → 向量列表」,候选依据是向量距离;本文保存的是「文本词项 → 文档列表」,候选依据是词法命中。二者共享倒排组织思想,不是同一种检索算法。
2. Analyzer 先定义什么是 term
Term Dictionary 不负责理解中文。它只保存 Analyzer 已经产出的字节序列;切错词之后,词典会非常高效地保存并查找这些错误结果。
一条典型分析链是:
原始字段
  → Character Filter
  → Tokenizer
  → Token Filter
→ token(term, position, startOffset, endOffset)- Character Filter:在切词前规范字符,例如去除 HTML、映射异体字符。
- Tokenizer:决定 token 边界。
- Token Filter:做大小写、宽窄字符、停用词、词干、同义词等转换。
- Token Stream:不仅有 term,还携带 position 与原文 offset。
2.1 CJK 不是某一种固定分词算法
CJK 是 Chinese、Japanese、Korean 的合称,描述的是一组文字系统,不等于「中文词典分词」。同一个字符串可以采用完全不同的 token 语义。
以 数据库索引 为例:
单字 unigram:
  数 / 据 / 库 / 索 / 引

重叠 bigram:
  数据 / 据库 / 库索 / 索引

词语分割:
  数据库 / 索引
Lucene 文档中的几类实现恰好展示了这些差异:
- CJK 包说明会用历史
ChineseAnalyzer展示单字方案,但这个类在 Lucene 10.x API 中已经不存在;现代代码若确实需要 unigram,应基于StandardTokenizer等组件自建 Analyzer,不能直接实例化ChineseAnalyzer。 CJKAnalyzer对相邻 CJK 字符产生重叠 bigram,并处理宽窄字符、大小写和停用词。默认不会同时保留 unigram,孤立且无法组成 bigram 的字符除外。SmartChineseAnalyzer使用内置统计词典和 HMM 为简体中文选择词语边界,API 标记为 experimental;领域新词与人名仍可能切错。- ICU analysis 更侧重 Unicode 分段、规范化与跨文字系统处理,不应直接等同于中文领域词典。
它们没有绝对优劣:
- 单字几乎不受未登录词影响,但 posting 更长,
数据库与「数、据、库」分别出现也可能产生噪声。 - bigram 仍不依赖完整词库,搜索新品名和组合词较稳;代价是 token 数增多,查询通常展开成多个相邻 bigram。
- 词语分割让词频和短语语义更直观,但「数据库索引」是
[数据库, 索引]还是[数据库索引]依赖词库、模型和领域配置。
因此,中文搜索的第一个工程问题不是「选哪个倒排算法」,而是:业务希望什么字符串在检索时被视为同一个 term?
2.2 索引期与查询期必须共享语义
如果索引期得到:
数据库索引 → [数据库, 索引]查询期却得到:
数据库索引 → [数据, 据库, 库索, 索引]两边只有「索引」可能直接相交。倒排索引不会回看原文猜测用户意图,它只能匹配已经写入的 term。
「使用同一个 Analyzer」是安全起点,但不意味着两边配置永远完全相同。例如索引期可保留同义词原词,查询期再把一个词展开为多个 OR 分支;关键是明确这种不对称会怎样改变召回与成本。
2.3 多字段比让一个 Analyzer 包办一切更可控
常见做法是把同一份标题写入多个逻辑字段:
title.zh       领域词语分割,用于主要相关性召回
title.cjk      重叠 bigram,用于未登录词与召回兜底
title.keyword  整个标题作为一个值,用于精确过滤、排序或聚合
它们在存储上是三套 term namespace 和 postings。查询可以让 title.zh 权重大、title.cjk 权重小,而不是把所有行为塞进一个不可解释的 Analyzer。
2.4 position 与 offset 不是装饰
Token Stream 中的附加信息决定后续能力:
position支持短语和邻近查询;positionIncrement能表达停用词留下的距离与同义词占据同一位置;startOffset/endOffset把 token 映射回原文区间,用于高亮;- payload 可以为某个位置附加业务数据,但会增加存储与解码成本。
若只需要「是否包含」,可以关闭 freq、position 或 offset;但这是索引协议的一部分,关闭后不能在查询时凭空恢复。
3. 从 Token Stream 到内存倒排结构
Analyzer 逐文档输出 token;索引器按
field → term → occurrences重新聚合,再一次性写成有序、不可变的 Segment。
处理 doc 1 时,内存中可以把出现记录理解为:
title
├─ 数据库
│  └─ doc 1: freq=2, positions=[0, 3]
├─ 索引
│  └─ doc 1: freq=1, positions=[1]
├─ 优化
│  └─ doc 1: freq=1, positions=[2]
└─ 实践
   └─ doc 1: freq=1, positions=[4]
继续接收文档后,同一 term 下追加新的 docID。达到内存阈值时,系统把 term、docID 和位置编码成有序文件并生成不可变 Segment。数据超出单批内存时,可以生成多个有序块再归并;经典 SPIMI(Single-Pass In-Memory Indexing)就是这类思路。
最终 Segment 中几类数据职责不同:
- Term Dictionary + Postings:从词项找文档,用于召回与评分。
- Stored Fields:按 docID 取回标题、正文等原始返回内容。
- Doc Values:面向列式扫描,用于排序、聚合和脚本。
- Norms:每文档、每字段的紧凑评分统计,例如字段长度。
Doc Values 和 Stored Fields 都不能替代全文倒排:它们的访问方向仍然以 docID 或列为中心。
4. Term Dictionary:一次查词到底发生了什么
词典的职责不是保存一个漂亮的
Map<String, List>,而是在海量有序 term 中快速判断「是否存在、统计是什么、postings 从哪里读」。
4.1 先看一份具体词典
四篇示例文档分析后,title 字段的词典可概念化为:
term        docFreq  totalTermFreq  postingsPointer
优化        2        2              0x120
原理        1        1              0x148
实践        1        1              0x160
数据仓库    1        1              0x178
数据库      3        4              0x1A0
查询        1        1              0x1D8
索引        3        3              0x1F0
设计        1        1              0x228
地址只是说明元数据会把 term 接到 postings,实际文件指针通常经过差分与变长编码,不会真以这张定长表落盘。保存 freq、position、offset 时,一个 term state 还可能分别形成 docStartFP、posStartFP、payStartFP 等入口,因此 postingsPointer 是概念缩写,不保证物理上只有一个指针。
单词查询 title:数据库 的路径是:
查询 Analyzer
  → term bytes: "数据库"
  → Term Index 根据前缀定位候选词块
  → 在词块中确认完整 term
  → 读取 docFreq / totalTermFreq / postings 元数据
  → 打开 postings,得到 doc 0、1、3
落到 Lucene API,一次 Segment 内查词大致对应:
Terms terms = leafReader.terms("title");
TermsEnum termsEnum = terms.iterator();

if (termsEnum.seekExact(new BytesRef("数据库"))) {
    int docFreq = termsEnum.docFreq();
    long totalTermFreq = termsEnum.totalTermFreq();
    PostingsEnum postings =
        termsEnum.postings(null, PostingsEnum.POSITIONS);
}
LeafReader 面向单个 Segment;上层 IndexReader 会把各 Segment 的 Terms / Postings 视图组合起来。TermsEnum 负责词典 seek 与枚举,PostingsEnum 才负责推进 docID、freq 和 positions。两层没有混成一个 Map。
Term Index 的前缀路径不存在时,查询可能在读取对应 .tim 词块前就判定失败;但 mmap 页面是否已驻留、底层是否发生真实磁盘 I/O 属于另一层问题,不能把它绝对化为「不存在 term 时零 I/O」。
4.2 为什么不只用哈希表
哈希适合 seekExact("数据库"),但全文词典还要支持有序操作。概念上,前缀查询等价于从前缀下界开始枚举,直到越过前缀范围:
数据*
  → seekCeil("数据")
  → 枚举 数据仓库
  → 枚举 数据库
  → 第一个不再以“数据”开头的 term 处停止
范围查询可以用 seekCeil(lowerBound) 后按序枚举。Lucene 的 PrefixQuery、Wildcard 和 Regex 则更进一步:模式会编译为自动机,Terms.intersect() 联合遍历自动机状态、BlockTree term blocks 与 floor blocks,直接跳过不可能匹配的分支,而不是找到第一个词后无条件扫描整份词典。前导 * 缺少固定前缀,仍可能逼近大范围枚举。
如果只有哈希表,就必须额外维护一份有序结构,或扫描全部 term。Term Dictionary 因而同时追求:
- 精确 seek;
- 按字节序枚举;
- 前缀共享和块压缩;
- 将热的导航结构留在内存,把完整词典按块放在磁盘或 page cache。
4.3 BlockTree 把相同前缀的 term 放进块
Lucene 的 BlockTree Terms Dictionary 按共享前缀组织 term block。一个 block 的 entry 可能是 term 后缀,也可能指向更深的 sub-block;过大的 block 会按下一个字节拆成 floor blocks。
以概念化的词项集合为例:
数据
├─ 仓库
├─ 库
│  ├─ 索引
│  └─ 查询
└─ 治理
索引层只需把前缀「数据」导向相应词块,块内再恢复后缀并查找完整 term。大量共同前缀不必在每一项里重复保存。
具体实现必须注明 codec 版本:
- Lucene 10 的
Lucene103BlockTree 中,.tim保存 term block 及每 term 的统计和 postings 元数据,.tmd保存字段级统计以及.tim/.tip的入口与边界,.tip使用每字段的稀疏 prefix trie 定位.timblock;它不是包含每个完整 term 的另一份 trie。 - 较早的
Lucene90BlockTree 在.tip中使用每字段 FST。FST 是某些 codec 的 term index 实现,不是「倒排索引必然含有 FST」。
这一区分很重要:BlockTree 是词典如何分块,trie/FST 是如何为这些块建立导航索引,逐 term postings metadata 再把词典项接到 .doc/.pos/.pay 数据流。 小 Segment 启用 compound file 时,这些逻辑文件还可能被打包进 .cfs/.cfe,不一定都以独立文件出现在目录中。
5. Posting List:词找到了,接下来读什么
每个 term 对应一条按 docID 递增的 posting list。单个 posting 可以包含:
posting
├─ docID       Segment 内部文档编号
├─ freq        term 在该字段出现次数
├─ positions   出现位置
├─ offsets     原文字符区间
└─ payloads    可选位置级附加值
不同字段可以选择不同精度:
| 保存内容 | 支持能力 | 主要代价 |
|---|---|---|
| docID | 包含、AND、OR、过滤 | 最省空间 |
| docID + freq | BM25 等词频评分 | 额外整数与解码 |
| 再加 positions | Phrase、邻近查询 | 高频词位置数据很大 |
| 再加 offsets / payloads | 高亮、自定义位置评分 | 更多 I/O 与存储 |
5.1 有序让多词查询不需要哈希
假设:
数据库 → [0, 1, 3]
索引   → [0, 1, 2]
两条升序列表用双指针即可求交为 [0, 1]。列表长度悬殊时,短表提供候选,长表调用 advance(target) 跳到首个不小于目标的 docID。
下一篇会沿这组数据展开 AND、OR、Phrase 与 BM25:
倒排索引(二):从 Posting Iterator 到 BM25 排序
5.2 有序也让 docID 容易压缩
一条较长列表:
[105, 107, 108, 130, 131]保存相邻差值 d-gap 后:
[105, 2, 1, 22, 1]除首项外,大部分 gap 变成小整数,更适合 Variable-Byte、Frame of Reference、PForDelta、SIMD-BP128 等编码。positions 也可以在单篇文档内保存位置差。
常见块编码取舍:
- Variable-Byte:实现简单、单值可解码,但至少按整字节占用。
- Frame of Reference:一块整数共享 bit width,适合 SIMD 批量解码;块内离群大值会抬高整块宽度。
- PForDelta:多数值定宽,异常值旁路保存,在压缩率和批量解码间折中。
压缩不一定让查询变慢。倒排读取常受内存带宽与 cache miss 限制;更小的块能留在 page cache 和 CPU cache,省下的数据搬运可能超过解码开销。
长列表还会保存 skip data。advance(10000) 可以跨过若干编码块,而不是执行上万次 nextDoc()。skip 元数据还要关联 freq、position 等流的文件位置,确保跳过 docID 后仍能继续读取同一 posting 的附加数据。
6. 为什么最终写成不可变 Segment
压缩 posting 适合批量顺序写,不适合在中间频繁插入。Lucene 用多个不可变 Segment 承接增量写入,再在后台归并。
以 Lucene / Elasticsearch 为现实模型:
- Refresh:发布包含新 Segment 的搜索视图,使文档可搜索;它不等同于完整持久化提交。
- 查询:在各 Segment 上分别查词、遍历 postings,再归并结果。
- 更新:写入新版本,并把旧 docID 标记删除;压缩 posting 不在原位置修改。
- 删除:先更新 live-doc bitmap,Merge 时再物理回收。
- Merge:把多个小 Segment 重写成大 Segment,减少查询扇出并回收删除空间,代价是 CPU、磁盘带宽与写放大。
- Translog:是 Elasticsearch 在 Lucene 之外提供的恢复日志,不属于倒排文件。
不可变带来的收益是:
- 词典、postings 和 skip 布局在发布后稳定;
- 读线程不必与写线程争抢同一份压缩结构;
- 文件可以直接利用操作系统 page cache;
- 查询时一个
IndexReader能看到一致的 Segment 集合。
对应代价是多 Segment 查询、删除空间延迟回收和后台 Merge 写放大。倒排索引没有消灭写成本,只是把随机原地更新转成批量顺序重写。
7. 把写入链路重新串起来
原始 title
  → Analyzer 定义 CJK token、position、offset
  → 按 field + term 聚合 occurrences
  → Term Dictionary 按前缀分块并保存统计 / postings 元数据
  → Posting List 按 docID 排序并压缩
  → norms / stored fields / doc values 旁路写出
  → 发布不可变 Segment
其中每层都在给下一层设定边界:
- Analyzer 改变 term,会同时改变词典规模、posting 长度、tf 和 df。
- 关闭 positions 能省大量空间,但 Phrase 查询随之失去精确验证依据。
- 更激进的压缩减少 I/O,却增加块解码成本。
- 更频繁 Refresh 降低可见延迟,却制造更多小 Segment 和 Merge 压力。
至此只解决了「怎样从词找到匹配文档」。当查询同时包含多个 term,还要回答两个问题:
- 多条 posting iterator 如何协同推进?
- 同时命中的文档为什么排在不同位置?
这两部分进入下一篇:从 Posting Iterator 到 BM25 排序。
延伸阅读
- Lucene CJK analysis package:历史单字方案、CJK bigram 与 SmartChineseAnalyzer 的行为对比。
- Lucene103 BlockTree Terms Dictionary:
.tim、.tmd、.tip与 prefix trie。 - Lucene103 Postings Format:doc、freq、position、payload 与 skip data 的文件布局。
- Introduction to Information Retrieval:倒排构建、词典与 postings 压缩的经典教材。
- Near real-time search:Refresh、Segment 与近实时可见性。
版权所有
版权归属: