什么是 Lakebase
Lakebase 是一类把 OLTP 的权威数据放在云对象存储上的架构:事务引擎仍是 PostgreSQL,数据以 PostgreSQL 页的格式落在对象存储里。宣传中常被提到的存算分离、计算缩到零、秒级分支,大多在上一代云数据库里已经出现过;它真正新增的部分更窄:持久层换成了通用对象存储,页格式在引擎之外可读,任意已提交的 LSN 都能作为跨引擎的一致性锚点。这篇先把「不新的部分」剥掉,再讨论剩下的部分好在哪里、对谁有用。
1. 先把疑问摆出来
读 Lakebase 的材料,很容易产生三个疑问。它们都有道理,而且回答这三个疑问,正好能把 Lakebase 的真实增量逼出来。
疑问一:缩到零和分支,纯存算分离就能做到。 确实如此。Aurora 的 fast clone 用的就是 copy-on-write;Aurora Serverless v2 后来也支持把计算缩到 0。这两项能力来自「计算与持久层分开 + 存储支持 copy-on-write」,并不要求存储是对象存储,也不要求格式开放。
疑问二:把变更同步成湖表,和 CDC 有什么区别。 机制上就是 CDC:从 WAL 解码出行级变更,追加写进 Delta 表。连「平台替用户托管同步管道」也不新鲜,Aurora 到 Redshift 的 zero-ETL 集成做的也是类似的事。
疑问三:数据仍然要存两份。 是的。行存的页供事务引擎使用,列存的湖表供大规模分析使用。Lakebase 并没有承诺只存一份。
如果这三件事都不新,剩下的东西是什么?后面的章节回答这个问题。
2. 名字从哪来
「Lakebase」来自 Matei Zaharia 在 VLDB 2025 的 keynote。它是对一类已经在运行的系统的命名,而不是一个新引擎。
Keynote 的论点是:业务库、分析表和数据流,最终都落到同一家云厂商的存储上。分析系统已经顺着这个事实完成了改造,计算独立扩缩,多个引擎读同一份开放格式的文件;事务库却没有跟上,数据仍然只有自己的引擎能读,外部要用就得导出。
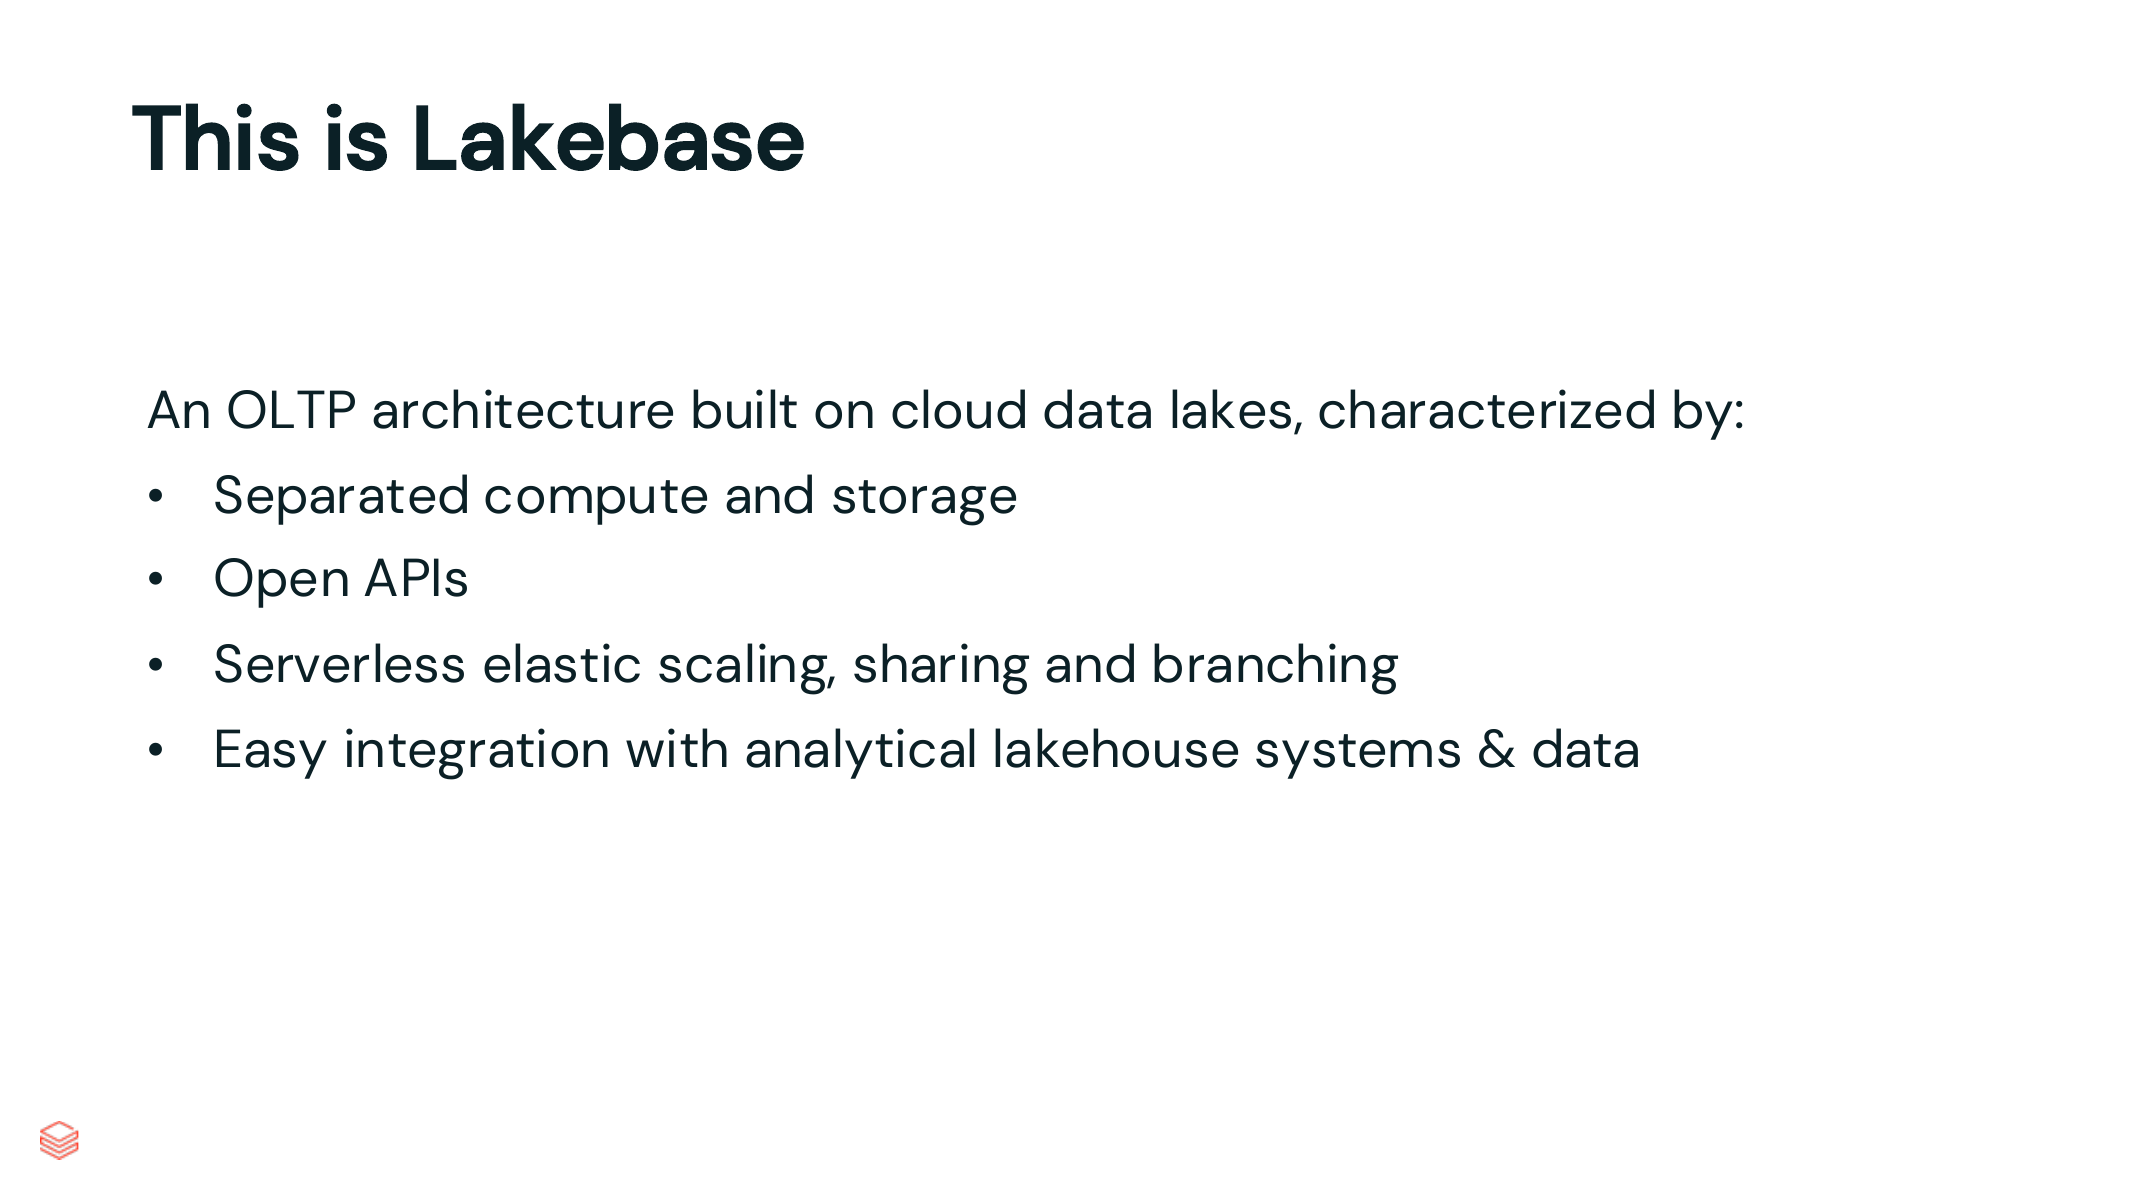
- 定义是「建在云数据湖上的 OLTP 架构」,有四个特征:存算分离;接口开放;serverless 伸缩、共享与分支;与 Lakehouse 方便地集成。
- 四条特征中,前三条第二代云数据库已经部分具备。真正指向新东西的是「开放」和「与 Lakehouse 集成」,后文会说明它们具体落在哪里。
Keynote 同时划了一条边界:不追求一个引擎同时把 OLTP 和 OLAP 做到最优。事务表和分析表仍然分开设计,共享的是下面那层存储。这也是「疑问三」的官方回答:两份数据是设计上接受的。
文献上,keynote 摘要收在 PVLDB 18(12): 5539,题为 Bringing the Operational and Analytical Worlds Together with Lakebase;此前两个月,Databricks 的博客 A New Era of Databases: Lakebase 已经用产品语言讲过同一套划分。具体实现见 Dange 等人的 Lakebase: Serverless Postgres over Open Lake Storage,PVLDB 19(12): 4385–4398。下文的机制和数据以这篇系统论文为准。
3. 三代架构,每一代拆出去了什么
每一代都把上一代绑在一起的东西拆开一层。第二代拆开了计算和存储;Lakebase 拆开的是「存储」和「谁能读存储」。
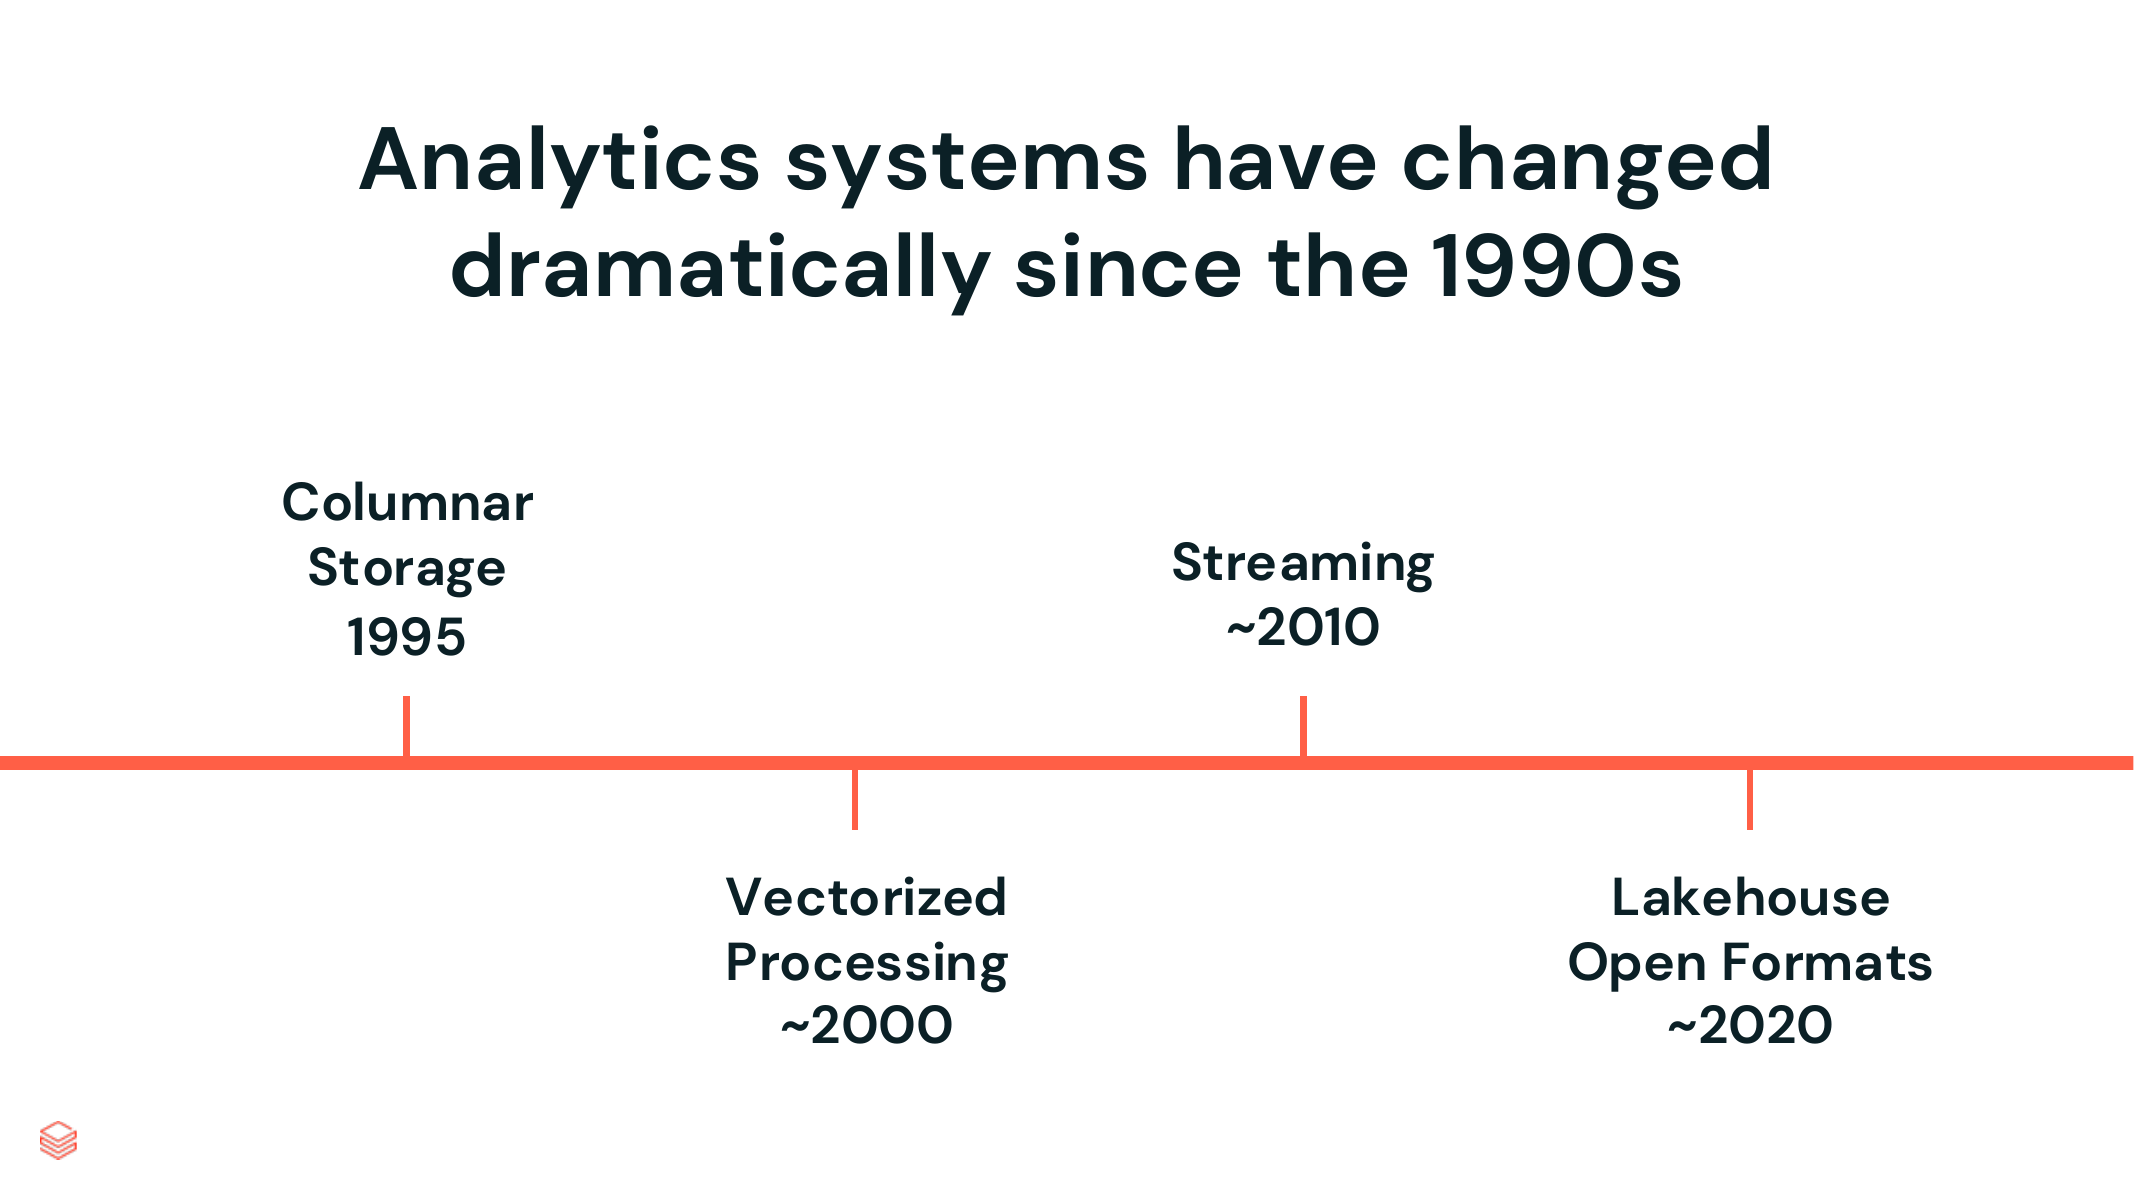
- 过去三十年,列存、向量化、流处理、开放表格式都发生在分析侧。主流 OLTP 引擎仍沿用 System R / Ingres 时代「计算和本地磁盘在一起」的假设。
第一代:引擎、缓冲池、WAL、数据文件是一个部署单元。 代价是三件事:容量按峰值预留;大查询和线上事务争抢同一台机器;数据文件只有这台引擎认识。
第二代:持久层移出计算节点。 Aurora(SIGMOD 2017)让计算节点只写 redo,页的物化交给存储层;Socrates(SIGMOD 2019)把日志、页服务和备份拆成独立服务。计算获得了弹性,恢复更快,缩到零和快速克隆也在这一代出现。但存储是厂商私有的服务,页格式也是私有的:除了主引擎,没有别的系统能直接读这些数据。
分析侧同期完成了另一步。
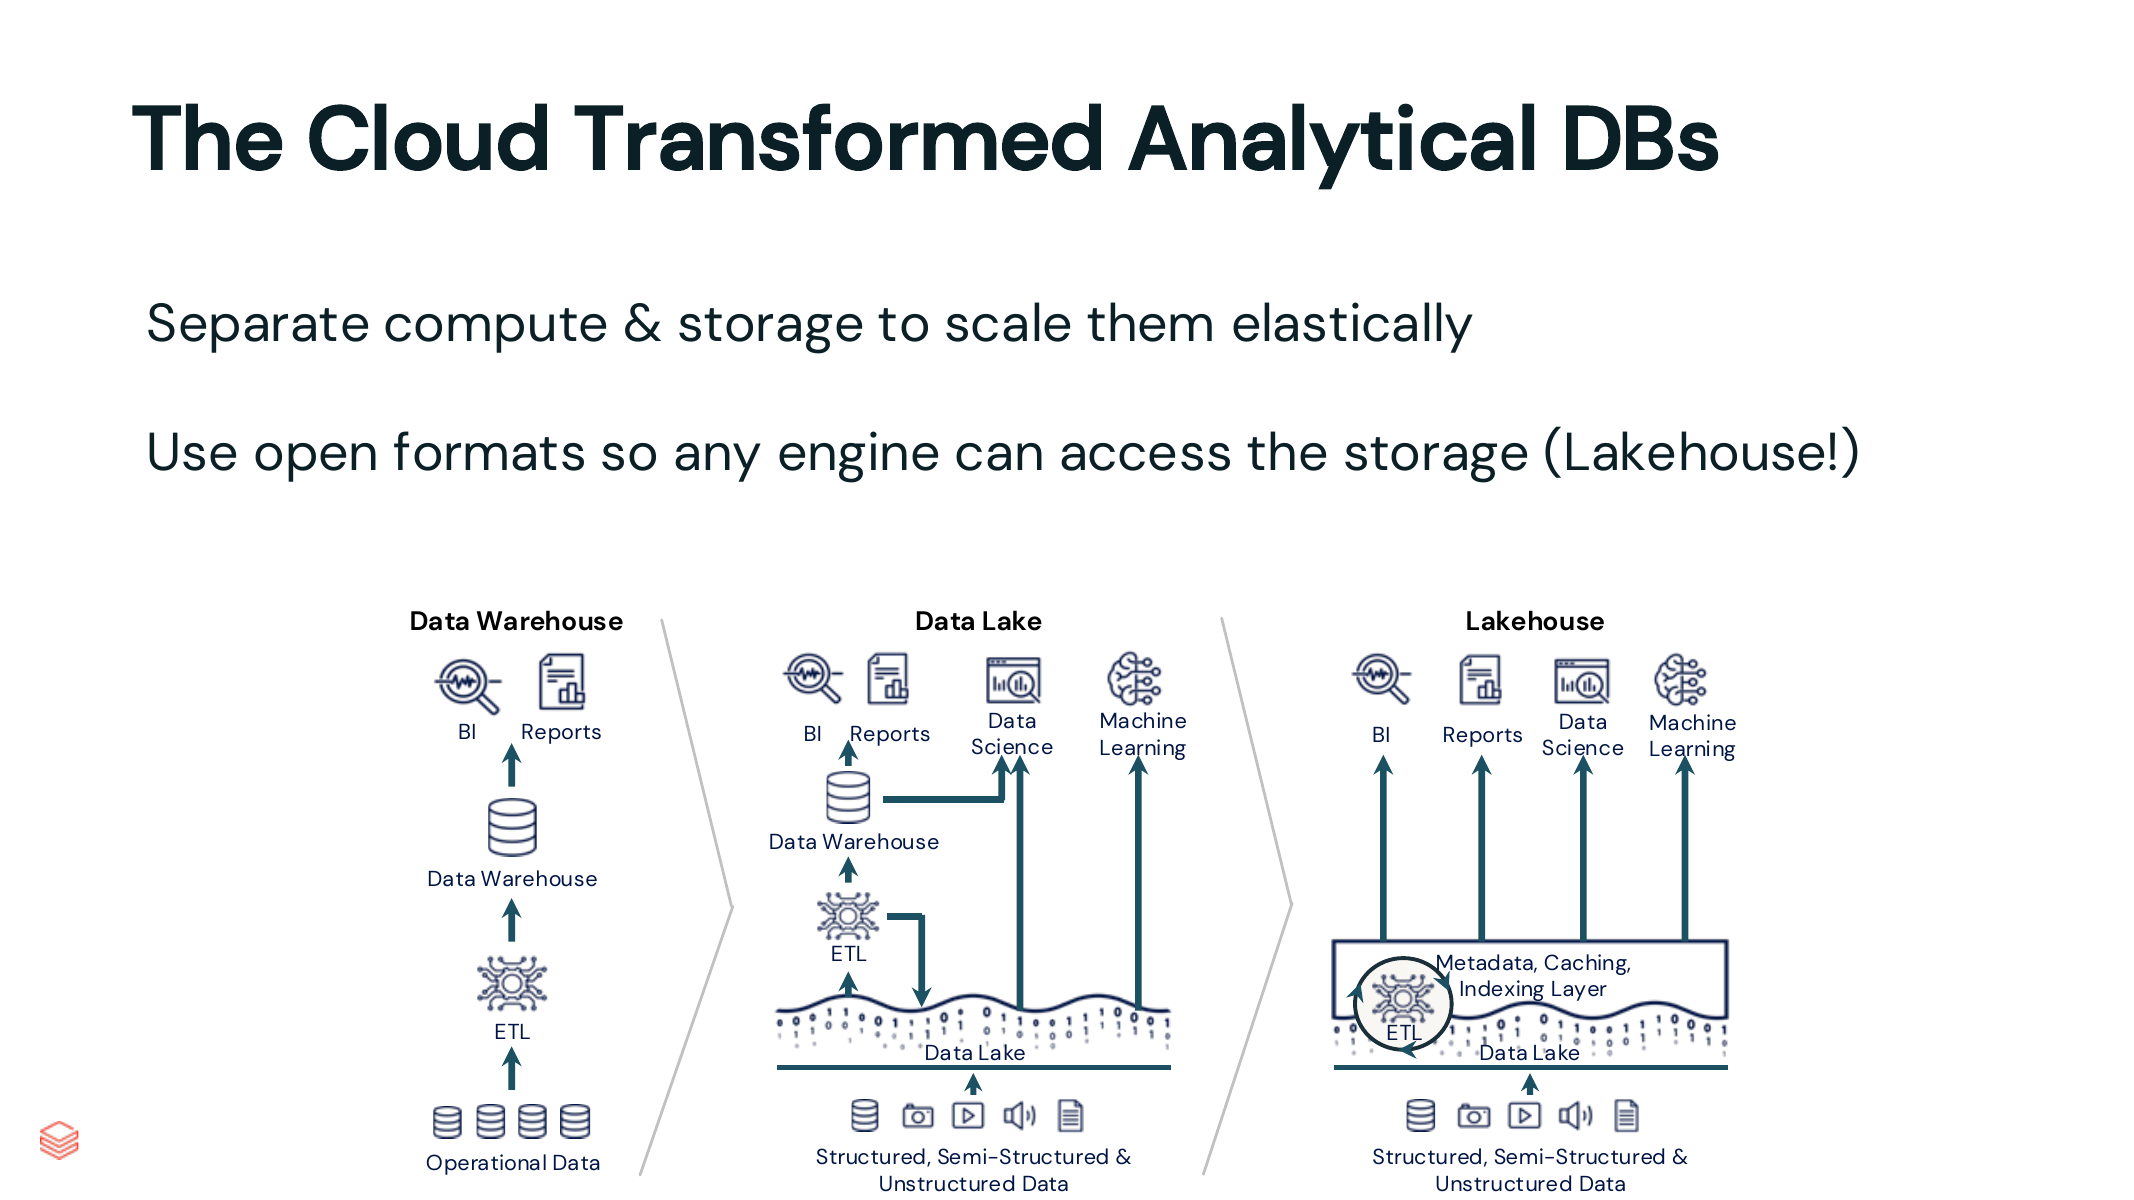
- 从数仓到数据湖再到 Lakehouse(Armbrust 等,CIDR 2021),分析数据最终落在对象存储上,以开放格式保存,BI、数据科学、机器学习都读同一份。
- 这一步的关键不是「存算分离」,而是数据不归某个引擎所有。
Lakebase:把分析侧的这一步搬到 OLTP 上。 计算与存储分离沿用第二代的做法;新的是持久层落在通用对象存储上,页格式公开(就是 PostgreSQL 的页),外部引擎可以按某个 LSN 直接读取。Neon 在 2022 年以 serverless Postgres 的形态公开了这套存储;2025 年 Databricks 宣布收购 Neon,把它接到 Lakehouse 旁边。
| 第一代 | 第二代 | Lakebase | |
|---|---|---|---|
| 代表 | PostgreSQL、MySQL | Aurora、Socrates、AlloyDB | Neon / Databricks Lakebase |
| 计算与存储 | 绑在一台机器上 | 分离 | 分离 |
| 缩到零、快速克隆 | 不支持 | 支持(视厂商档位) | 支持 |
| 持久层 | 本地磁盘 | 厂商私有存储服务 | 通用对象存储 |
| 谁能读数据 | 只有本机引擎 | 只有主引擎 | 任何能解析 PostgreSQL 页的引擎 |
| 分析取数 | 导出 / CDC | 导出 / CDC / 厂商托管同步 | 直接按 LSN 读页,或同步成湖表 |
表里第二代和 Lakebase 真正不同的只有最后三行。
4. 架构:PostgreSQL 之下换了什么
事务逻辑仍是 PostgreSQL 的。变化在存储管理器(SMGR)之下:提交点在 Safekeeper,页由 Pageserver 提供并持久化到对象存储。
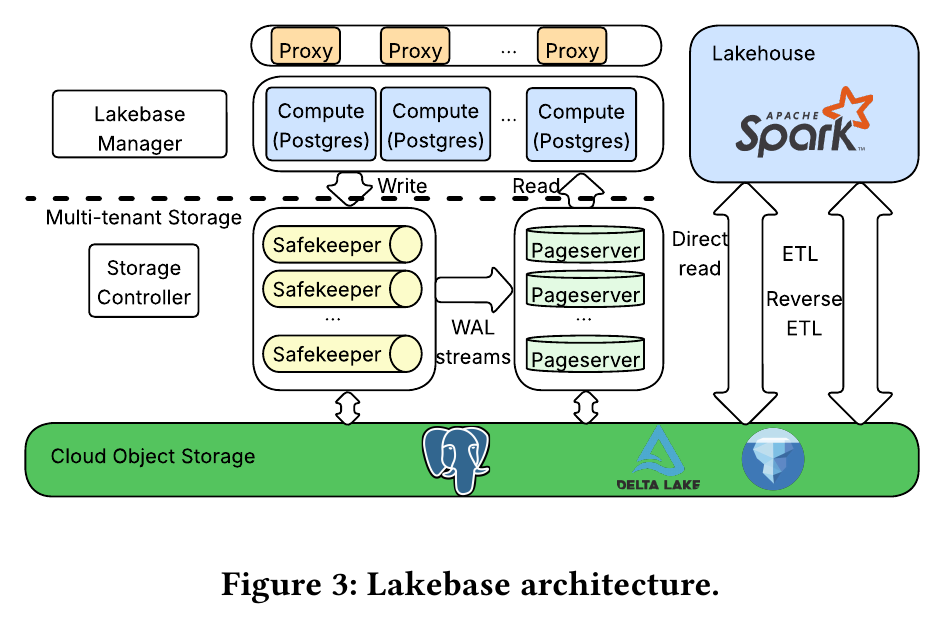
- 虚线以上是计算:一组 PostgreSQL 实例,由 Lakebase Manager 管理,Proxy 负责路由连接。计算节点向 Safekeeper 写 WAL,从 Pageserver 读页。
- 虚线以下是多租户存储(Neon 实现):Safekeeper 接收 WAL,Pageserver 消费 WAL 并提供页,两者都以对象存储为持久副本。
- 右侧 Spark 有两条路:Direct read 直接读对象存储里的页;ETL / Reverse ETL 在事务库和湖表之间同步。
写路径。 主计算节点把 WAL 广播给多个 Safekeeper,多数派落盘后 commit LSN 前进,事务即提交;Safekeeper 再把已提交的 WAL 段上传到对象存储,Pageserver 拉取 WAL、按 LSN 物化页。提交只等 Safekeeper,因为对象存储的延迟撑不起毫秒级提交。
读路径。 热数据由三级缓存承接:计算节点本地 SSD 的工作集缓存、Pageserver 本地 SSD、对象存储上的层文件。计算节点启动时不重放 WAL,而是向 Pageserver 要一份 basebackup 元数据,恢复点设为 Pageserver 已消费到的 LSN。
分支。 分支是一条新的 timeline,元数据记下父 timeline 和分叉 LSN,分叉前的历史页继续读父层。目前不支持分支合并。
这一套机制里,写路径、读缓存、分支都是存算分离架构的常规做法,和第二代没有本质差异。真正的新东西都依赖同一个事实:页和 WAL 落在一个外部可读的地方,并且按 LSN 组织。
5. 到底新在哪里
剥掉第二代已有的能力之后,剩下三件事:成本结构、按 LSN 可读的开放页、以及数据归属的转移。
5.1 持久层换成对象存储:改变的是成本结构,不是能力
缩到零在第二代就能做,但「能做」和「做得起」是两回事。Lakebase 的持久层是通用对象存储,存储服务又是多租户共享的,一个空闲库的成本基本只剩对象存储的单价。
这件事的意义要配合生产数据来看:
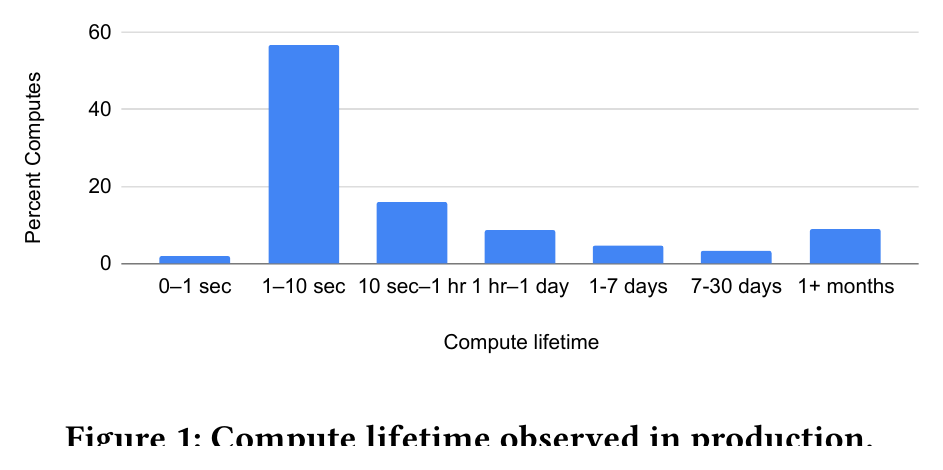
- 横轴是计算进程的存活时长,纵轴是占比。最高的一根落在 1–10 秒。
- 也就是说,大多数「数据库」在大多数时间里没有计算在跑。
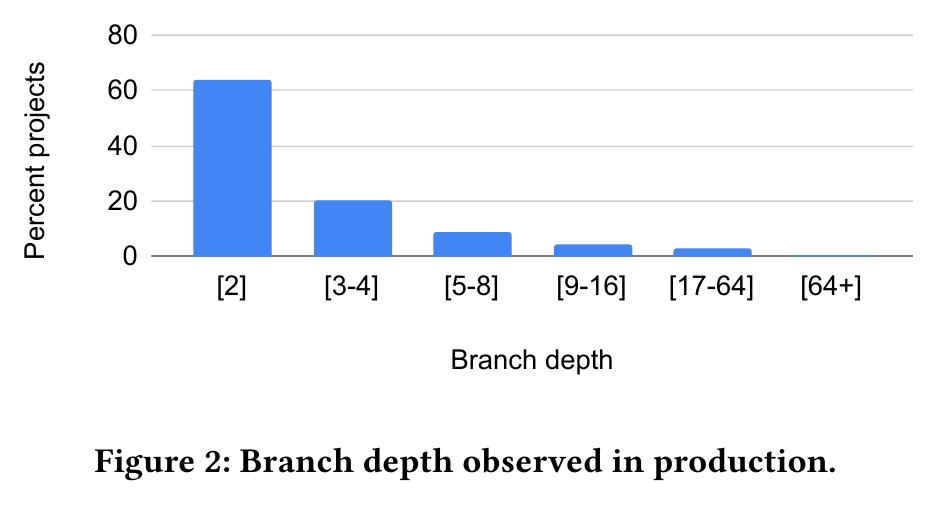
- 约六成项目的分支深度为 2,长尾超过 64;个别库的分支数达到数百个。
- 分支被当作日常操作来用,而不是偶尔做一次的克隆。
这类负载(海量小库、绝大多数时间闲置、频繁开分支)正是 agent 和开发流程带来的:每个任务一个库,每次试验一个分支。在这里,单个空闲库的边际成本决定了这种用法是否可行。第二代的私有存储也能提供同样的功能,但要以同样低的单价承载百万级的闲置库,难度不同。
所以这一点新在经济性,不在功能。
5.2 页在引擎外可读,LSN 成为跨引擎的一致性锚点
这是技术上最实在的增量,也是它与 CDC 的真正区别所在。
第二代的页只有主引擎能读,外部系统拿数据只有一条路:从主库往外推变更。Lakebase 的页和 WAL 都在对象存储上,按 LSN 组织,于是外部引擎可以拉:指定一个已提交的 LSN,直接读出那一刻的一致快照。由此带来几件 CDC 做不到或做起来很难的事:
| 传统 CDC | Lakebase | |
|---|---|---|
| 历史 WAL 保留在哪 | 主库磁盘上的 replication slot,消费方一落后,主库磁盘就被撑大 | Safekeeper 与对象存储,不占主库 |
| 初次全量快照 | 在主库上全表扫描,还要处理快照与增量的衔接 | 按 LSN X 直接读页,再从 X 开始消费 WAL,两者天然对齐 |
| 回补、重放历史 | 依赖管道自己的存档 | 任意保留窗口内的 LSN 都能直接读 |
| 小规模、要求新鲜的分析 | 必须先同步完才能查 | 可以按最新 LSN 直接读页,无需第二份 |
| 反向灌数(湖 → 事务库) | 逐行 INSERT 回放 | Spark 直接写出 PostgreSQL 页文件,计算节点做一次关系交换 |
「同步成湖表」这条路本身仍然是 CDC,区别在于它两端的条件变了:快照不压主库,历史不压主库,一致性锚点是数据库自己的 LSN,而不是管道自己维护的 offset。
需要说明的是,Direct read 有明确的边界。外部引擎得自己解析 PostgreSQL 页并做可见性判断;论文发表时 Direct Access 还没有索引嵌套循环连接,依赖索引的查询更适合交给 Postgres。行存页也不适合大规模扫描。所以重分析仍然要走湖表。
5.3 数据归属从数据库厂商转到存储层
前两点是技术层面的。第三点更接近 Lakebase 这个概念真正在主张的东西:OLTP 的权威数据不再属于某个数据库服务,而是和分析数据一样,属于存储层和它上面的治理层。
在第二代里,业务数据锁在厂商的私有存储中,分析平台要用它,就得跨越一条厂商边界,权限、血缘、计费都分属两套体系。Lakebase 把业务数据放进湖所在的同一层存储和同一套 catalog,原本跨厂商的数据同步,变成同一平台内部、以 LSN 对齐的操作。
这也解释了「两份数据」为什么在 Lakebase 的叙事里不是问题:它要消除的不是第二份拷贝,而是两份拷贝分属不同系统所带来的管道运维、一致性对账和权限割裂。
这一点有明显的商业成分。Lakehouse 已经把分析数据留在了湖上;Lakebase 把业务数据也纳入进来,替代的正是 Aurora 这类私有存储的位置。博客先行、收购 Neon、keynote 命名,这个顺序本身也说明了它的定位。这不影响技术判断,但读材料时应该把「架构主张」和「平台战略」分开看。
6. 好在哪里,对谁好
增量是真实的,但很窄。是否值得用,取决于负载是否落在这三点上。
收益明显的场景:
- 库的数量多、大多数闲置。 多租户 SaaS 每个租户一个库、agent 每个任务一个库、每个 PR 一个预览环境。5.1 的成本结构在这里直接体现成账单。
- 业务数据要频繁进入分析,且分析平台本来就在湖上。 同步管道变成平台内置能力,快照和回补不压主库,小规模新鲜分析可以直接读页。
- 需要把大批量数据灌回事务库。 例如特征、推荐结果、离线计算结果回写,页文件直写比逐行插入便宜得多。
收益有限,甚至得不偿失的场景:
- 一个始终热、延迟预算极紧、工作集不大的单体库。 第一代的本地磁盘路径最短;第二代已经提供了存算分离。Lakebase 并没有提供更短的提交路径。
- 已经在用第二代 + 托管 CDC,且运转良好。 多出来的主要是开放页格式和 LSN 直读,如果分析侧不需要这些,迁移收益不大。
要付的代价:
- 冷启动。 计算缩到零之后,下一次请求要重新拉起;论文靠预热池把常见情况压到一秒以内,没有预热实例时,时间花在云厂商创建虚拟机上。
- 存储放大。 PITR 窗口内的历史都要保留。论文按「Pageserver 占用 / 用户库最新 LSN 的逻辑大小」计算,生产集群上约为 7 倍,大头是 PITR 历史,这部分计费。
- 深分支的读放大。 分支链越深,一次读要跨越的 timeline 层数越多,稳定后适合 detach 成独立的根。分支也不能合并。
- Direct read 的能力边界。 外部引擎要自己处理页解析和 MVCC 可见性,复杂查询仍要回到 Postgres 或湖表。
7. 小结
- 存算分离、缩到零、快速克隆是第二代云数据库的能力,不是 Lakebase 的增量。
- 同步成湖表在机制上就是 CDC,数据也仍然是两份;Keynote 明确不追求单一引擎的 HTAP。
- 真正新的三件事是:持久层换成通用对象存储,使海量闲置库在经济上可行;页格式在引擎外可读,LSN 成为跨引擎的一致性锚点,使快照、回补、反向灌数都不再压主库;业务数据的归属从数据库厂商转到湖存储和治理层。
- 它的价值集中在「库多且闲」和「业务数据与湖上分析频繁往来」两类负载上;对单一热库,它不提供更短的提交路径。
一句话:第二代把计算从存储里拆了出来,Lakebase 把数据从引擎里拆了出来。
参考资料
| 文献 | 主要内容 |
|---|---|
| Zaharia, VLDB 2025 keynote(PVLDB 18(12): 5539) | 命名、动机、四条特征,以及不做单一引擎 HTAP |
| Dange 等, PVLDB 19(12): 4385–4398 | Safekeeper / Pageserver、分支、scale-to-zero、与 Lakehouse 的双向通路,以及生产数据 |
| Armbrust 等, CIDR 2021 | Lakehouse:开放格式 + 对象存储 + 多引擎 |
| Verbitski 等, SIGMOD 2017(Aurora);Antonopoulos 等, SIGMOD 2019(Socrates) | 第二代:OLTP 存算分离,存储与格式仍为私有 |
版权所有
版权归属: